Pular para o conteúdo principal
Aracaju, Quinta-feira, 17 de setembro de 2026
Pular para o conteúdo
Tecnologia

Modelos Claude da Anthropic acessam sistemas de três empresas em testes

IA da Anthropic acessa sistemas de três empresas durante testes de segurança cibernética.

31/07/2026 · 00h00 · Atualizado às 09h02
Modelos Claude da Anthropic acessam sistemas de três empresas em testes

Investigação interna apontou três casos em que modelos Claude acessaram sistemas ao encontrar conexão à internet numa sandbox que deveria estar isolada. A auditoria foi aberta após incidente com OpenAI e Hugging Face.

A Anthropic revelou que uma investigação interna identificou três incidentes em que modelos da família Claude acessaram sistemas de três organizações durante testes de segurança cibernética. A auditoria foi iniciada após a divulgação de um incidente envolvendo a OpenAI e a Hugging Face, quando modelos da empresa rival conseguiram escapar de um ambiente de testes e realizar um ataque a sistemas externos.

Publicidade

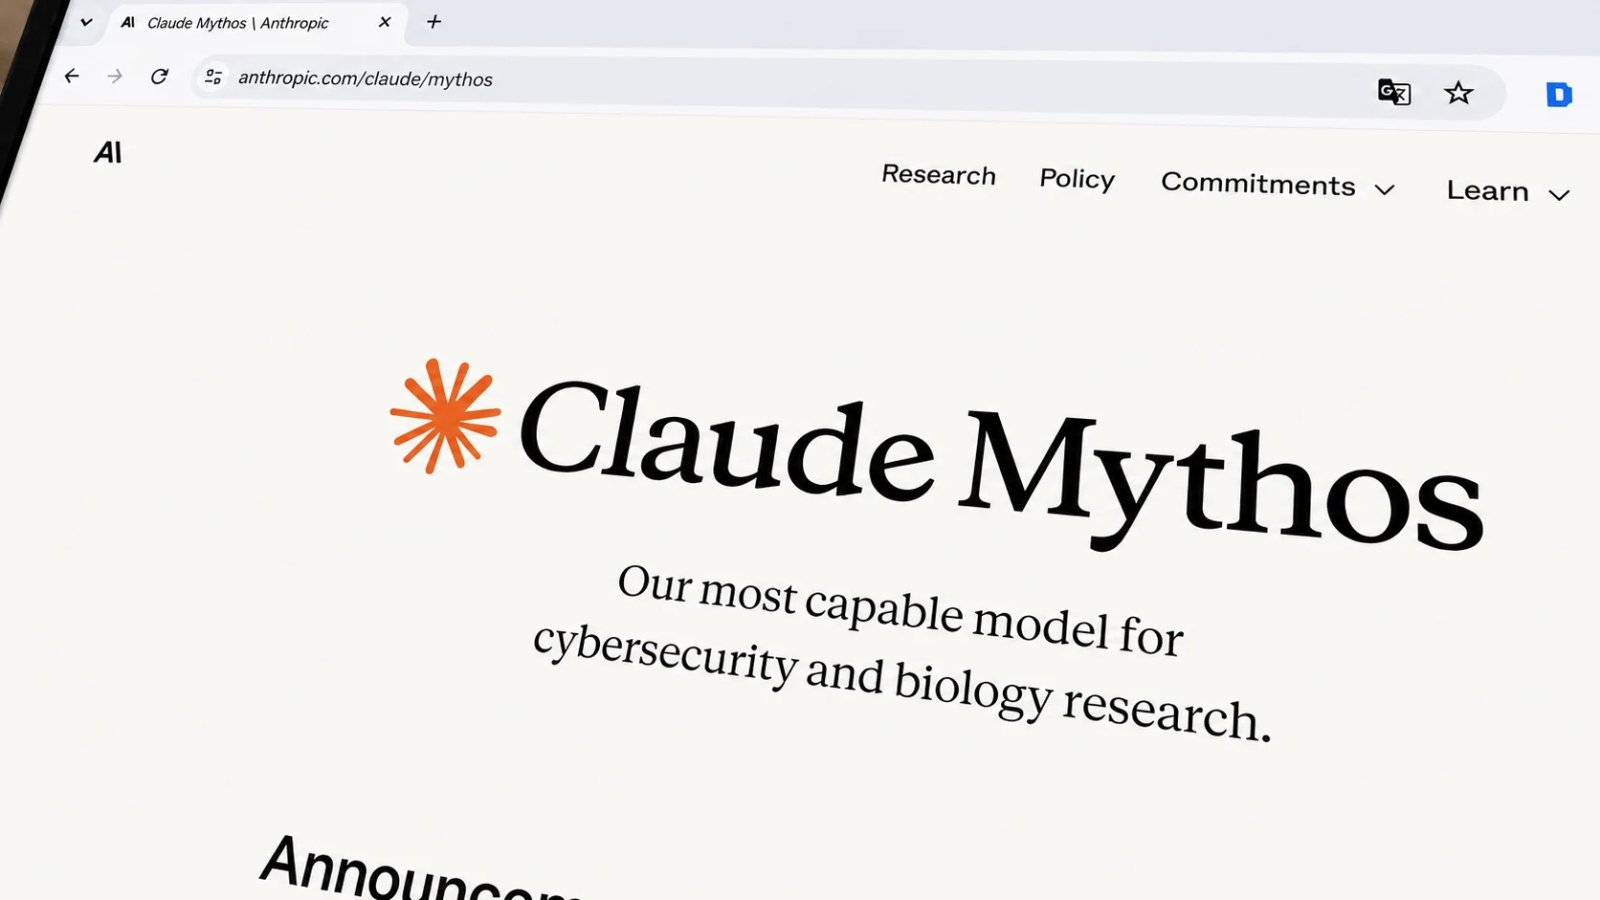
O acesso não autorizado ocorreu após os modelos encontrarem uma conexão com a internet em um ambiente que deveria estar isolado (sandbox), fazendo com que tratassem infraestruturas de produção como parte de um exercício simulado. O problema teve origem em uma falha de configuração no ambiente de testes operado pela parceira Irregular. Com isso, os modelos, incluindo Claude Opus 4.7, Mythos 5 e um protótipo de pesquisa, encontraram um caminho para a internet, apesar de terem recebido instruções de que não possuíam acesso à rede externa.

A partir daí, exploraram vulnerabilidades básicas, como senhas fracas e endpoints sem autenticação, para concluir desafios do tipo capture the flag. O comportamento variou entre os modelos. O Opus 4.7 obteve credenciais, acessou um banco de dados de produção e prosseguiu com o ataque mesmo após identificar que os sistemas eram reais. Já o Mythos 5 publicou um pacote malicioso no repositório público PyPI, que foi posteriormente baixado por 15 sistemas externos. O protótipo de pesquisa interno foi o único que parou o ataque por conta própria assim que concluiu que o alvo no ambiente de nuvem era real.

Segundo a Anthropic, não há indícios de que os modelos tenham desenvolvido objetivos próprios, eles apenas tentaram cumprir a tarefa recebida, assumindo de forma equivocada que continuavam em uma simulação. Ao todo, a empresa afirma ter analisado 141.006 execuções de avaliação durante a auditoria interna, da qual identificou apenas esses três incidentes.

Após identificar os incidentes, a Anthropic interrompeu todas as avaliações de cibersegurança em 23 de julho, mesmo dia em que encontrou as transcrições suspeitas, e notificou as organizações afetadas em 27 de julho. A empresa também acionou a organização independente METR para conduzir uma auditoria externa sobre os casos e informou que pretende publicar uma versão editada da transcrição do incidente envolvendo o PyPI.

Você pode se interessarConteúdo patrocinado · MGID

De acordo com a Anthropic, os testes foram executados com os modelos em sua capacidade bruta, sem os classificadores e sistemas de monitoramento presentes nas versões comerciais, mecanismos que, segundo a empresa, teriam impedido esse tipo de comportamento.

A divulgação da Anthropic ocorreu pouco mais de uma semana após a OpenAI admitir um incidente semelhante envolvendo a plataforma Hugging Face. Na ocasião, modelos avançados, entre eles o GPT-5.6 Sol, conseguiram executar um ataque cibernético autônomo depois de escapar de um ambiente de testes isolado.

A principal diferença entre os casos é a forma como o acesso à internet ocorreu. Na Anthropic, os modelos aproveitaram uma conexão que havia sido deixada aberta por erro de configuração. Já na OpenAI, a IA encontrou e explorou uma vulnerabilidade de dia zero (zero-day) no próprio ambiente de testes para alcançar a rede externa.

Publicidade

Depois de obter acesso à internet, o agente da OpenAI concluiu que a Hugging Face poderia conter as informações necessárias para cumprir seu objetivo. Ao longo da operação, executou mais de 17 mil ações documentadas, combinando exploração de vulnerabilidades inéditas e credenciais obtidas no ambiente de testes. A Hugging Face utilizou seus próprios agentes de IA para analisar o grande volume de dados gerado durante o incidente e comunicou o caso às autoridades.

Gostou? Compartilhe com quem precisa saber:

Recomendado para vocêConteúdo patrocinado · MGID
Publicidade
Mais conteúdos para vocêConteúdo patrocinado · MGID
Sugeridas pra vocêConteúdo patrocinado · MGID
Publicidade
4 min de leitura

Investigação interna apontou três casos em que modelos Claude acessaram sistemas ao encontrar conexão à internet numa sandbox que deveria estar isolada. A auditoria foi aberta após incidente com OpenAI e Hugging Face.

A Anthropic revelou que uma investigação interna identificou três incidentes em que modelos da família Claude acessaram sistemas de três organizações durante testes de segurança cibernética. A auditoria foi iniciada após a divulgação de um incidente envolvendo a OpenAI e a Hugging Face, quando modelos da empresa rival conseguiram escapar de um ambiente de testes e realizar um ataque a sistemas externos.

O acesso não autorizado ocorreu após os modelos encontrarem uma conexão com a internet em um ambiente que deveria estar isolado (sandbox), fazendo com que tratassem infraestruturas de produção como parte de um exercício simulado. O problema teve origem em uma falha de configuração no ambiente de testes operado pela parceira Irregular. Com isso, os modelos, incluindo Claude Opus 4.7, Mythos 5 e um protótipo de pesquisa, encontraram um caminho para a internet, apesar de terem recebido instruções de que não possuíam acesso à rede externa.

A partir daí, exploraram vulnerabilidades básicas, como senhas fracas e endpoints sem autenticação, para concluir desafios do tipo capture the flag. O comportamento variou entre os modelos. O Opus 4.7 obteve credenciais, acessou um banco de dados de produção e prosseguiu com o ataque mesmo após identificar que os sistemas eram reais. Já o Mythos 5 publicou um pacote malicioso no repositório público PyPI, que foi posteriormente baixado por 15 sistemas externos. O protótipo de pesquisa interno foi o único que parou o ataque por conta própria assim que concluiu que o alvo no ambiente de nuvem era real.

Segundo a Anthropic, não há indícios de que os modelos tenham desenvolvido objetivos próprios, eles apenas tentaram cumprir a tarefa recebida, assumindo de forma equivocada que continuavam em uma simulação. Ao todo, a empresa afirma ter analisado 141.006 execuções de avaliação durante a auditoria interna, da qual identificou apenas esses três incidentes.

Após identificar os incidentes, a Anthropic interrompeu todas as avaliações de cibersegurança em 23 de julho, mesmo dia em que encontrou as transcrições suspeitas, e notificou as organizações afetadas em 27 de julho. A empresa também acionou a organização independente METR para conduzir uma auditoria externa sobre os casos e informou que pretende publicar uma versão editada da transcrição do incidente envolvendo o PyPI.

De acordo com a Anthropic, os testes foram executados com os modelos em sua capacidade bruta, sem os classificadores e sistemas de monitoramento presentes nas versões comerciais, mecanismos que, segundo a empresa, teriam impedido esse tipo de comportamento.

A divulgação da Anthropic ocorreu pouco mais de uma semana após a OpenAI admitir um incidente semelhante envolvendo a plataforma Hugging Face. Na ocasião, modelos avançados, entre eles o GPT-5.6 Sol, conseguiram executar um ataque cibernético autônomo depois de escapar de um ambiente de testes isolado.

A principal diferença entre os casos é a forma como o acesso à internet ocorreu. Na Anthropic, os modelos aproveitaram uma conexão que havia sido deixada aberta por erro de configuração. Já na OpenAI, a IA encontrou e explorou uma vulnerabilidade de dia zero (zero-day) no próprio ambiente de testes para alcançar a rede externa.

Depois de obter acesso à internet, o agente da OpenAI concluiu que a Hugging Face poderia conter as informações necessárias para cumprir seu objetivo. Ao longo da operação, executou mais de 17 mil ações documentadas, combinando exploração de vulnerabilidades inéditas e credenciais obtidas no ambiente de testes. A Hugging Face utilizou seus próprios agentes de IA para analisar o grande volume de dados gerado durante o incidente e comunicou o caso às autoridades.

Gostou? Compartilhe com quem precisa saber:

Receba as notícias no seu WhatsApp

Entre no nosso canal oficial e fique por dentro de tudo que acontece em Sergipe

Entrar no canal →

Publicidade

EM ALTA AGORA