

Evite ficar sem créditos no pior momento: controle o uso e estenda sua franquia. Saiba práticas simples para reduzir tokens e gastos ao usar modelos de linguagem.
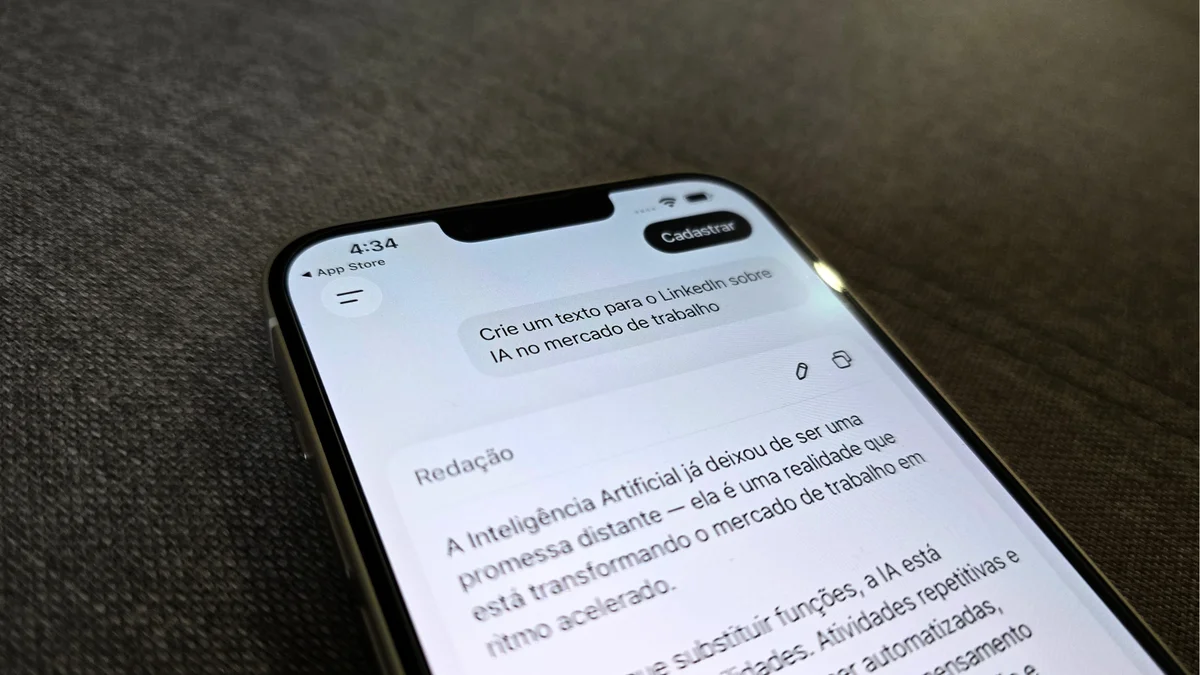
É frustrante perceber que os limites do plano de IA foram atingidos durante uma tarefa, forçando esperar, assinar outro plano ou migrar de serviço. Para reduzir esse risco, existem medidas práticas que ajudam a economizar créditos e tokens nas interações com modelos de linguagem.
Os principais serviços do mercado operam com limites de uso baseados no poder computacional de cada comando: prompts curtos e simples costumam garantir mais uso diário, enquanto uma tarefa muito extensa pode consumir boa parte da franquia do plano de uma só vez. A seguir, sete orientações para controlar esse consumo sem perder produtividade.
7 dicas para não gastar os limites de uso da IA
- Alterne entre diferentes serviços — Divida as tarefas pelo nível de complexidade: use o plano mais avançado da IA para comandos desafiadores e modelos mais simples ou gratuitos para prompts rotineiros. O ChatGPT, por exemplo, não tem limites de uso para mensagens na versão gratuita, o que pode servir como alternativa para delegar alguns prompts.
- Acompanhe os limites de uso — Monitore a tela de limites de cada serviço para entender o impacto das tarefas no dia a dia. Plataformas como Gemini, ChatGPT e Claude oferecem painéis com o tempo restante até a restauração dos limites e medidores do que já foi gasto, quando esse recurso estiver disponível no seu plano.
- Otimize os arquivos — Enviar arquivos mais leves ajuda a reduzir o consumo de créditos. Converter um PDF para Markdown facilita a leitura automática, e transformar uma planilha composta só por texto e números para CSV otimiza a interpretação dos dados pelos modelos.
- Coloque todos os pedidos no mesmo prompt — Reunir todas as solicitações no prompt inicial evita que a IA releia e reanalise informações repetidas a cada novo comando, o que consome mais poder computacional. Por exemplo, ao pedir comparativos de celulares por custo-benefício, inclua todas as instruções e critérios no primeiro prompt.
- Ajuste o tamanho da resposta — Modelos consomem tokens na entrada e na saída. Solicitar um tamanho específico de resposta reduz a geração de textos mais longos do que o necessário e torna o uso mais econômico. Essa prática também é recomendada por orientações oficiais de provedores de modelos.
- Crie novas conversas — Quando a informação anterior não é essencial para a nova tarefa, abra um chat novo. Em uma mesma conversa, a IA relembra e processa todo o histórico a cada prompt, o que aumenta o consumo de limites.
- Remova regras repetidas — Se o primeiro prompt já contém todas as regras (formato, tom, tamanho), não as repita nas interações seguintes. Reduzir redundâncias economiza tokens e simplifica a execução das tarefas.
“remover instruções repetidas e exemplos, além de simplificar descrições da ferramenta podem melhorar o desempenho da tarefa e a eficiência de tokens”
Adotar essas práticas ajuda a esticar a franquia do plano e a escolher quando usar modelos mais robustos ou alternativas gratuitas. Otimização de arquivos, organização dos pedidos e acompanhamento dos limites são passos simples que fazem diferença no controle de custos.
LEIA TAMBÉM

Receba as notícias no seu WhatsApp
Entre no nosso canal oficial e fique por dentro de tudo que acontece em Sergipe
Entrar no canal →